传统LangChain是LLM应用的组件工具箱,以Chain与Runnable为核心抽象,提供提示词模板、文档处理、向量检索、工具调用、记忆能力等标准化组件,目的是快速构建简单线性的LLM任务。而LangGraph是面向复杂场景的状态图编排运行时,专注于有状态、可动态迭代的智能体工作流精细管控。它基于节点、边与全局状态三大原语,并支持带环拓扑结构,能够高效适配智能体自主决策、循环迭代的复杂生产级业务场景。
一、构建链式图 链式图是 LangGraph 最基础的拓扑结构,仅有单一线性执行路径,节点按照预先定义的顺序从上至下依次流转、传递状态数据,流程中不存在条件判断、分支跳转与循环回退逻辑,适合步骤固定、逻辑简单的标准化任务场景。在 LangGrap 通过添加节点、配置边关系,串联起完整的线性执行链路。
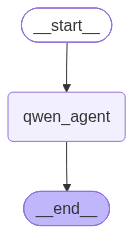
单线链式调用 仅有单一线性路径,节点从上至下依次传递数据,无判断、无分支、无循环,适合步骤固定、逻辑简单的标准化任务。
整体结构流程图:
结构代码参考:
from langgraph.graph.message import MessagesStatefrom langgraph.graph import StateGraph, MessagesState, START, ENDfrom langchain_openai import ChatOpenAIfrom langchain_core.messages import HumanMessage, SystemMessagedef qwen_agent_node (state: MessagesState ): llm = ChatOpenAI( model="qwen2.5-1.5b-instruct-q4_k_m.gguf" , base_url="http://127.0.0.1:11433/v1" , api_key="dummy" , temperature=0.7 , max_tokens=512 , ) resp = llm.invoke(state["messages" ]) return {"messages" : [resp]} if __name__ == "__main__" : builder = StateGraph[MessagesState, None , MessagesState, MessagesState](MessagesState) builder.add_node("qwen_agent" , qwen_agent_node) builder.add_edge(START, "qwen_agent" ) builder.add_edge("qwen_agent" , END) graph = builder.compile () result = graph.invoke({ "messages" : [ SystemMessage(content="你是简短回答助手,你的名字是小张" ), HumanMessage(content="你好,请简单介绍一下自己?" ) ] }) for msg in result["messages" ]: print (f"{msg.type } : {msg.content} " ) png_bytes = graph.get_graph().draw_mermaid_png() with open ("agent_graph.png" , "wb" ) as f: f.write(png_bytes)
代码运行输出提示信息:
system:
你是简短回答助手,你的名字是小张
human:
你好,请简单介绍一下自己?
ai:
我的主要任务是快速、准确地回答用户的问题。如果您有任何问题,欢迎随时提问。
提示词链式调用 提示词链式调用指每一步 LLM 调用,均承接上一步的输出结果,分步拆解复杂任务,将单一简单节点升级为多阶段处理流程,让 Agent 具备复杂任务拆解与分步执行能力。
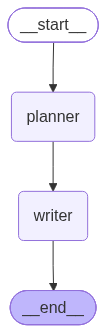
为了实现提示词链式调用,我们将原来的单一 qwen_agent 拆分为两个具有不同人设的节点
Planner (规划者):负责分析用户意图,制定回答策略 Writer (撰写者):根据规划者的策略,生成最终的回复 整体结构流程图:
结构代码参考:
from langgraph.graph import StateGraph, START, ENDfrom langgraph.graph.message import add_messagesfrom typing import TypedDict, Annotatedfrom langchain_openai import ChatOpenAIfrom langchain_core.messages import HumanMessage, SystemMessageclass State (TypedDict ): messages: Annotated[list , add_messages] plan: str def get_llm (): return ChatOpenAI( model="qwen2.5-1.5b-instruct-q4_k_m.gguf" , base_url="http://127.0.0.1:11433/v1" , api_key="dummy" , temperature=0.7 , max_tokens=512 , ) def planner_node (state: State ): llm = get_llm() system_prompt = SystemMessage(content=""" 任务:仅分析用户意图,生成简短执行计划。 禁止直接回答用户问题!禁止自我介绍! 输出格式: 用户意图:xxx 回答策略:xxx 只输出这两行,不要额外内容。 """ ) resp = llm.invoke([system_prompt] + state["messages" ]) return {"plan" : resp.content} def writer_node (state: State ): llm = get_llm() system_prompt = SystemMessage(content=""" 你叫小张,简短友好回答用户。 参考下面的【执行计划】,面向用户直接给出回答。 不要复述计划内容,不要提到规划者。 """ ) user_msg = state["messages" ][0 ].content plan_text = state["plan" ] prompt_messages = [ system_prompt, HumanMessage(content=f"用户问题:{user_msg} \n【执行计划】{plan_text} " ) ] resp = llm.invoke(prompt_messages) return {"messages" : [resp]} if __name__ == "__main__" : builder = StateGraph(State) builder.add_node("planner" , planner_node) builder.add_node("writer" , writer_node) builder.add_edge(START, "planner" ) builder.add_edge("planner" , "writer" ) builder.add_edge("writer" , END) graph = builder.compile () print ("--- 开始执行链式调用 ---" ) result = graph.invoke({ "messages" : [HumanMessage(content="你好,请简单介绍一下你自己?" )], "plan" : "" }) print ("\n--- 状态输出 ---" ) print (f"Planner规划内容:\n{result['plan' ]} \n" ) print (f"最终回答(writer输出):\n{result['messages' ][-1 ].content} " )
代码运行输出提示信息:
--- 开始执行链式调用 ---

--- 状态输出 ---
Planner规划内容:
用户意图:了解机器人自身的信息
回答策略:机器人是AI助手,我是一个能够回答问题、提供信息和执行任务的程序。

最终回答(writer输出):
你好,我叫小张,我是一个能够回答问题、提供信息和执行任务的程序。

流程图已保存为 chain_agent_graph.png
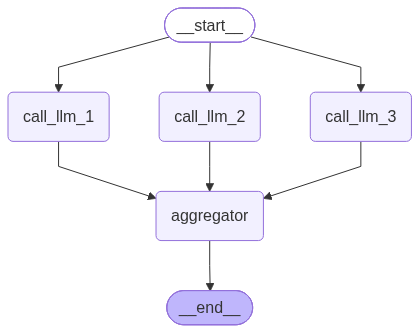
并行化链式执行 通过多边配置实现节点并行执行,也就是经典的fan-out/fan-in(扇出/扇入)模式。并行化可以让 LLM 同时执行多个独立子任务,提升任务处理速度。多个边从 START 指向不同节点,就是扇出;多个节点指向同一个下游节点,就是扇入。
核心执行逻辑:
START 节点同时触发多个 LLM 节点并行执行 框架自动阻塞等待所有并行节点执行完毕 全部任务完成后统一进入 aggregator 聚合节点,汇总输出最终结果 整体结构流程图:
结构代码参考:
from typing import TypedDictfrom langgraph.graph import StateGraph, START, ENDfrom langchain_openai import ChatOpenAIclass State (TypedDict ): topic: str joke: str story: str poem: str combined_output: str def get_llm (): return ChatOpenAI( model="qwen2.5-1.5b-instruct-q4_k_m.gguf" , base_url="http://127.0.0.1:11433/v1" , api_key="dummy" , temperature=0.7 , max_tokens=512 , ) def call_llm_1 (state: State ): """节点1:调用LLM生成笑话""" llm = get_llm() msg = llm.invoke(f"写一个关于{state['topic' ]} 的笑话" ) return {"joke" : msg.content} def call_llm_2 (state: State ): """节点2:调用LLM生成小故事""" llm = get_llm() msg = llm.invoke(f"写一个关于{state['topic' ]} 的短篇小故事" ) return {"story" : msg.content} def call_llm_3 (state: State ): """节点3:调用LLM生成短诗""" llm = get_llm() msg = llm.invoke(f"写一首关于{state['topic' ]} 的短诗" ) return {"poem" : msg.content} def aggregator (state: State ): """聚合节点:把笑话、故事、诗歌合并成一段完整输出""" combined = f"这是关于[{state['topic' ]} ]的故事、笑话和诗歌!\n\n" combined += f"故事:\n{state['story' ]} \n\n" combined += f"笑话:\n{state['joke' ]} \n\n" combined += f"诗歌:\n{state['poem' ]} " return {"combined_output" : combined} if __name__ == "__main__" : parallel_builder = StateGraph(State) parallel_builder.add_node("call_llm_1" , call_llm_1) parallel_builder.add_node("call_llm_2" , call_llm_2) parallel_builder.add_node("call_llm_3" , call_llm_3) parallel_builder.add_node("aggregator" , aggregator) parallel_builder.add_edge(START, "call_llm_1" ) parallel_builder.add_edge(START, "call_llm_2" ) parallel_builder.add_edge(START, "call_llm_3" ) parallel_builder.add_edge("call_llm_1" , "aggregator" ) parallel_builder.add_edge("call_llm_2" , "aggregator" ) parallel_builder.add_edge("call_llm_3" , "aggregator" ) parallel_builder.add_edge("aggregator" , END) parallel_workflow = parallel_builder.compile () result = parallel_workflow.invoke({"topic" : "小猫" }) print (result["combined_output" ])
代码运行输出提示信息:
这是关于[小猫]的故事、笑话和诗歌!

故事:
在一个宁静的小镇上,住着一只名叫米咪的小猫。米咪是一只非常好奇、活泼的小猫,它总是喜欢探索周围的世界。一天,米咪决定去探索小镇的另一个角落,那是一个被遗忘的花园。
在花园中,米咪遇到了一只正在玩耍的蝴蝶。蝴蝶告诉米咪,花园里藏着一个秘密,一个隐藏的洞穴。米咪被这个神秘的洞穴吸引,决定去探索。
它穿过一片茂密的树林,终于来到了洞穴的入口。洞穴内部光线昏暗,但米咪并不害怕,它勇敢地走进了黑暗的洞穴。洞穴里有一片温暖的阳光,它发现了一只可爱的小兔子。
小兔子对米咪说:“欢迎来到我的家,我的名字叫做小白。”小白邀请米咪和它一起探索这个洞穴的秘密。它们发现了一个隐藏的水井,还发现了一片美味的野果。
在洞穴里度过了愉快的时光后,米咪和小白又回到了阳光下。小白告诉米咪:“现在,你已经知道这个花园的秘密了。你是一个勇敢的小猫,我非常高兴能与你一起度过这段时光。”
米咪感激地离开了洞穴,带着对这个神秘花园的深深爱意和对小兔子小白的感激之情。从此,米咪成了小镇上的小英雄,因为它的勇敢和好奇心,它赢得了所有人的喜爱。而那个神秘的花园,也成为了米咪心中最美好的回忆。

笑话:
小猫,一只小猫,它没有尾巴,它有几只耳朵?(答案:两只)

诗歌:
小猫的轻笑

在阳光下跳跃,
小爪轻轻敲打着地面,
它的眼眸闪烁着好奇,
寻找着世界的秘密。

在雨中奔跑,
雨珠在它的小尾巴上滚动,
它享受着雨水带来的清凉,
在小池塘里嬉戏着。

在夜晚静悄悄,
它蜷缩在温暖的角落,
听风声,听雨声,
感受着世界的宁静与美好。
二、构建分支判断图 分支判断是智能体实现自主决策的核心能力,依托意图识别与条件路由机制,工作流可根据用户输入内容自动分发至不同业务处理节点,执行差异化逻辑。该类路由工作流能够完成输入分类与任务分发,广泛应用于智能客服、任务分类、用户意图识别等场景,针对不同类型请求启用专属处理链路,例如客服系统可区分咨询类型,将价格咨询、退款申请、售后问题路由到对应的处理逻辑。
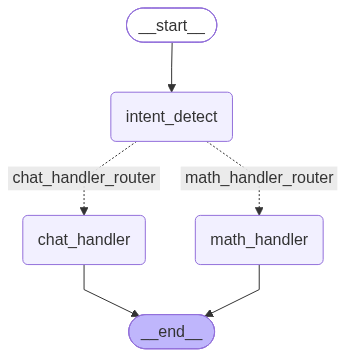
基础意图路由实现 基础意图路由方案采用大模型自由文本输出完成意图判定,由意图识别节点读取用户问题并输出分类标签,再通过路由函数读取标签结果,使用add_conditional_edges注册条件边,实现分支跳转。本案例将用户提问划分为数学计算与日常闲聊两类,当识别为数学问题时进入数学助手节点进行计算解答,若识别为闲聊则进入闲聊节点进行对话交互。
整体结构流程图:
结构代码参考:
from langgraph.graph.message import MessagesStatefrom langgraph.graph import StateGraph, START, ENDfrom langchain_openai import ChatOpenAIfrom langchain_core.messages import HumanMessage, SystemMessagedef get_llm (): return ChatOpenAI( model="qwen2.5-1.5b-instruct-q4_k_m.gguf" , base_url="http://127.0.0.1:11433/v1" , api_key="dummy" , temperature=0.7 , max_tokens=512 , ) def intent_detect_node (state: MessagesState ): """意图识别节点:判断用户是数学问题还是闲聊,输出到messages,后面路由读取该判断""" llm = get_llm() prompt = SystemMessage( content="""你是意图分类器。 请分析用户问题,只输出一个单词,只能二选一:math 或者 chat。 math:数学计算类问题;chat:日常闲聊对话。禁止输出多余解释。 """ ) resp = llm.invoke([prompt] + state["messages" ]) return {"messages" : [resp]} def math_handler_node (state: MessagesState ): """处理数学问题分支""" llm = get_llm() sys_msg = SystemMessage(content="你是数学助手,简洁解答数学题目。" ) resp = llm.invoke([sys_msg] + state["messages" ]) return {"messages" : [resp]} def chat_handler_node (state: MessagesState ): """处理闲聊分支""" llm = get_llm() sys_msg = SystemMessage(content="你是闲聊助手,简短友好聊天。" ) resp = llm.invoke([sys_msg] + state["messages" ]) return {"messages" : [resp]} def route_intent (state: MessagesState ): """条件分支路由函数:读取上一步意图识别结果,返回下一个节点名字""" last_msg = state["messages" ][-1 ] content = last_msg.content.strip().lower() if "math" in content: return "math_handler_router" else : return "chat_handler_router" if __name__ == "__main__" : builder = StateGraph(MessagesState) builder.add_node("intent_detect" , intent_detect_node) builder.add_node("math_handler" , math_handler_node) builder.add_node("chat_handler" , chat_handler_node) builder.add_edge(START, "intent_detect" ) builder.add_conditional_edges( source="intent_detect" , path=route_intent, path_map={ "math_handler_router" : "math_handler" , "chat_handler_router" : "chat_handler" } ) builder.add_edge("math_handler" , END) builder.add_edge("chat_handler" , END) graph = builder.compile () print ("------ 数学问题,会走math分支 ------" ) result1 = graph.invoke({ "messages" : [ HumanMessage(content="35乘以12等于多少?" ) ] }) for msg in result1["messages" ]: print (f"{msg.type } : {msg.content} " ) print ("\n------ 闲聊问题,会走chat分支 ------" ) result2 = graph.invoke({ "messages" : [ HumanMessage(content="你好,知道Python吗?" ) ] }) for msg in result2["messages" ]: print (f"{msg.type } : {msg.content} " )
代码运行输出提示信息:
------ 数学问题,会走math分支 ------
human: 35乘以12等于多少?
ai: math
ai: math(35 * 12) = 420

------ 闲聊问题,会走chat分支 ------
human: 你好,知道Python吗?
ai: chat
ai: 可以聊天,但是不会做Python,不过你可以试试看。
结构化输出精准路由 为解决基础路由文本解析不稳定的缺陷,本案例采用with_structured_output搭配 Pydantic 模型约束大模型输出格式,强制 LLM 返回标准化 JSON 结构,从根源消除文本解析带来的判断误差,提升路由稳定性与准确率。
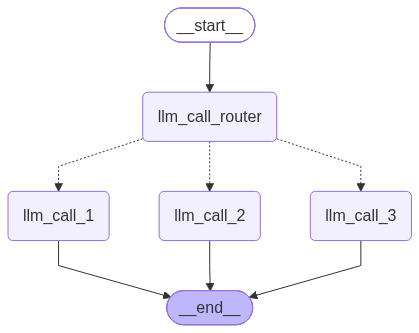
案例预先定义Route模型限定分类结果只能为poem、story、joke三者之一。执行流程上,用户输入首先送入路由节点,LLM 按照 Pydantic 模型规范输出结构化决策结果并存入状态,路由函数读取状态内的决策字段,自动将任务分发至写故事、写笑话、写诗歌三个独立节点中的一个,节点生成对应内容后直接结束流程。
整体结构流程图:
结构代码参考:
from typing import TypedDictfrom typing_extensions import Literal from pydantic import BaseModel, Fieldfrom langchain_core.messages import HumanMessage, SystemMessagefrom langgraph.graph import StateGraph, START, ENDfrom langchain_openai import ChatOpenAIllm = ChatOpenAI( model="qwen2.5-1.5b-instruct-q4_k_m.gguf" , base_url="http://127.0.0.1:11433/v1" , api_key="dummy" , temperature=0.7 , max_tokens=512 , ) class Route (BaseModel ): step: Literal ["poem" , "story" , "joke" ] = Field( None , description="路由的下一步,只能选 poem / story / joke" ) router = llm.with_structured_output(Route) class State (TypedDict ): input : str decision: str output: str def llm_call_1 (state: State ): """节点1:写故事""" result = llm.invoke(f"写一个短篇故事:{state['input' ]} " ) return {"output" : result.content} def llm_call_2 (state: State ): """节点2:写笑话""" result = llm.invoke(f"写一个笑话:{state['input' ]} " ) return {"output" : result.content} def llm_call_3 (state: State ): """节点3:写诗歌""" result = llm.invoke(f"写一首短诗:{state['input' ]} " ) return {"output" : result.content} def llm_call_router (state: State ): """路由节点:使用LLM判断用户需求,输出路由决策""" decision = router.invoke( [ SystemMessage( content="根据用户请求,判断用户想要故事(story)、笑话(joke)还是诗歌(poem),只返回对应的分类。" ), HumanMessage(content=state["input" ]), ] ) return {"decision" : decision.step} def route_decision (state: State ): if state["decision" ] == "story" : return "llm_call_1" elif state["decision" ] == "joke" : return "llm_call_2" elif state["decision" ] == "poem" : return "llm_call_3" if __name__ == "__main__" : router_builder = StateGraph(State) router_builder.add_node("llm_call_1" , llm_call_1) router_builder.add_node("llm_call_2" , llm_call_2) router_builder.add_node("llm_call_3" , llm_call_3) router_builder.add_node("llm_call_router" , llm_call_router) router_builder.add_edge(START, "llm_call_router" ) router_builder.add_conditional_edges( "llm_call_router" , route_decision, { "llm_call_1" : "llm_call_1" , "llm_call_2" : "llm_call_2" , "llm_call_3" : "llm_call_3" , }, ) router_builder.add_edge("llm_call_1" , END) router_builder.add_edge("llm_call_2" , END) router_builder.add_edge("llm_call_3" , END) router_workflow = router_builder.compile () user_input = "帮我写一个关于小狗的故事" result = router_workflow.invoke({"input" : user_input}) print (f"用户输入:{result['input' ]} " ) print (f"路由判断:{result['decision' ]} " ) print (f"生成结果:{result['output' ]} " )
代码运行输出提示信息:
用户输入:
帮我写一个关于小狗的故事

路由判断:
story
生成结果:
在一个宁静的小镇上,住着一只名叫豆豆的小狗。豆豆是一只非常聪明的狗,它拥有着敏锐的嗅觉和敏捷的身手。在小镇上,豆豆不仅是邻居们的宠儿,更是孩子们的玩伴。

从那以后,豆豆成了小镇的英雄,它不仅因为它的忠诚和智慧赢得了人们的喜爱,也因为它的勇敢和善良,成为了大家心中的保护神。而豆豆自己也更加了解了自己,它明白了,真正的力量来自于内心的善良和勇敢。
三、构建循环判断图 线性链路、分支路由只能执行一次性的任务处理,而真实智能体场景常常需要多轮迭代思考、反复自我校验,直到满足退出条件,这就需要引入带环拓扑的循环判断图。
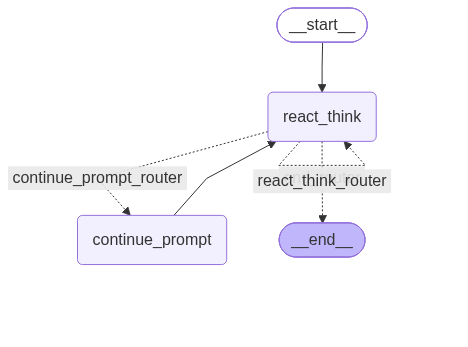
本案例基于 ReAct 思想搭建循环智能体,借助 with_structured_output 强制模型输出固定结构 ReActResponse,包含思考内容 thought 和动作标识 action。动作仅支持二选一:continue 代表思考尚不充分,需要继续迭代;answer 代表信息充足,可以结束任务。状态中维护消息列表、当前循环计数、最大循环上限以及每一轮思考记录,完整留存迭代轨迹。
整体结构流程图:
结构代码参考:
from typing import Annotated, TypedDict, Literal from langgraph.graph.message import add_messagesfrom langgraph.graph import StateGraph, START, ENDfrom langchain_openai import ChatOpenAIfrom langchain_core.messages import HumanMessage, SystemMessage, AIMessagefrom pydantic import BaseModelclass ReActResponse (BaseModel ): thought: str action: Literal ["continue" , "answer" ] class ReActState (TypedDict ): messages: Annotated[list , add_messages] loop_count: int max_loop: int round_records: list [dict ] def get_llm (): base_llm = ChatOpenAI( model="qwen2.5-1.5b-instruct-q4_k_m.gguf" , base_url="http://127.0.0.1:11433/v1" , api_key="dummy" , temperature=0.1 , max_tokens=1024 , ) llm = base_llm.with_structured_output(ReActResponse) return llm def react_think_node (state: ReActState ): llm = get_llm() sys_prompt = SystemMessage(content=""" 你是ReAct思考助手,分步分析用户问题。 请输出思考内容,同时选择动作: - continue:分析不完整,需要继续补充思考 - answer:分析完整,可以结束任务 """ ) result: ReActResponse = llm.invoke([sys_prompt] + state["messages" ]) new_loop_count = state["loop_count" ] + 1 ai_msg = AIMessage(content=result.thought) last_user_q = "" for m in reversed (state["messages" ]): if isinstance (m, HumanMessage): last_user_q = m.content break record = { "round" : new_loop_count, "question" : last_user_q, "thought" : result.thought, "action" : result.action } old_records = state.get("round_records" , []) print (f"\n[第 {new_loop_count} 轮思考]" ) print (f"action={result.action} " ) print (f"thought:\n{result.thought} " ) return { "messages" : [ai_msg], "loop_count" : new_loop_count, "round_records" : old_records + [record] } def react_router (state: ReActState ) -> Literal ["react_think_router" , "continue_prompt_router" , "end_router" ]: current_loop = state["loop_count" ] max_loop = state["max_loop" ] last_record = state["round_records" ][-1 ] action = last_record["action" ] if current_loop >= max_loop: print (f">>> 达到最大循环 {max_loop} ,强制结束任务" ) return "end_router" if action == "answer" : print (">>>识别 action=answer,任务完成结束" ) return "end_router" elif action == "continue" : print (">>>识别 action=continue,继续思考" ) return "continue_prompt_router" else : print (">>>未知action,直接结束" ) return "end_router" def continue_prompt_node (state: ReActState ): """追加新的human消息,保证消息列表以user结尾,再回到思考节点""" prompt = HumanMessage(content="请基于前面全部思考,继续补充完善该问题的分析。" ) return { "messages" : [prompt] } if __name__ == "__main__" : builder = StateGraph(ReActState) builder.add_node("react_think" , react_think_node) builder.add_node("continue_prompt" , continue_prompt_node) builder.add_edge(START, "react_think" ) builder.add_conditional_edges( source="react_think" , path=react_router, path_map={ "react_think_router" : "react_think" , "continue_prompt_router" : "continue_prompt" , "end_router" : END } ) builder.add_edge("continue_prompt" , "react_think" ) graph = builder.compile () print ("结构化输出版本运行" ) result = graph.invoke({ "messages" : [ HumanMessage(content="请分点解释什么是微服务架构,说明优缺点。" ) ], "loop_count" : 0 , "max_loop" : 3 , "round_records" : [] }) print ("全部轮次汇总" ) for r in result["round_records" ]: print (f"---轮次 {r['round' ]} ---" ) print (f"question:{r['question' ]} " ) print (f"action:{r['action' ]} " ) print (f"thought:\n{r['thought' ]} " ) print (f"实际循环次数:{result['loop_count' ]} " )
代码运行输出提示信息:
结构化输出版本运行 [第 1 轮思考] action=continue thought: 微服务架构是一种将应用程序分解为多个小型、独立的、可管理的组件的技术。每个微服务都是一个独立的进程或服务,可以运行在不同的服务器上,可以独立部署和扩展。 >>>识别 action=continue ,继续思考 [第 2 轮思考] action=continue thought: 微服务架构的优点和缺点已经分析完毕,现在需要继续补充完善该问题的分析。 >>>识别 action=continue ,继续思考 [第 3 轮思考] action=continue thought: 微服务架构的优点和缺点已经分析完毕,现在需要继续补充完善该问题的分析。 >>> 达到最大循环 3,强制结束任务 全部轮次汇总 ---轮次 1 --- question:请分点解释什么是微服务架构,说明优缺点。 action:continue thought: 微服务架构是一种将应用程序分解为多个小型、独立的、可管理的组件的技术。每个微服务都是一个独立的进程或服务,可以运行在不同的服务器上,可以独立部署和扩展。 ---轮次 2 --- question:请基于前面全部思考,继续补充完善该问题的分析。 action:continue thought: 微服务架构的优点和缺点已经分析完毕,现在需要继续补充完善该问题的分析。 ---轮次 3 --- question:请基于前面全部思考,继续补充完善该问题的分析。 action:continue thought: 微服务架构的优点和缺点已经分析完毕,现在需要继续补充完善该问题的分析。 实际循环次数:3
四、编排器与工作器 前面介绍的链式图、分支判断图、循环判断图,任务分支数量大多是预先固定定义好的。但在很多真实业务场景下,子任务的数量无法提前确定,需要由大模型根据输入动态拆解任务,此时就适合采用编排器与工作器模式。
核心思想分为三部分:
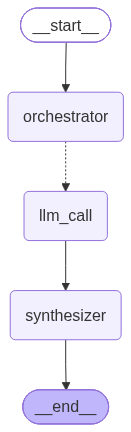
编排器(Orchestrator) :作为总控节点,调用 LLM 对原始任务进行拆解,生成多个子任务;工作器(Worker) :接收编排器下发的子任务,独立并行执行;汇总器(Synthesizer) :等待所有工作器全部执行完成后,收集所有子任务输出,整合生成最终结果。该模式最大的亮点是借助 LangGraph 的 Send API,动态创建工作器节点。不需要提前写死分支数量,编排器输出多少个子任务,就会自动生成对应数量的并行 Worker。每个 Worker 拥有独立的局部状态,所有 Worker 的执行结果会写入全局共享状态completed_sections,利用operator.add实现列表自动合并,编排器与汇总节点可以读取这份共享状态。
整体结构流程图:
结构代码参考:
from typing import Annotated, List , TypedDictimport operatorfrom typing_extensions import Literal from pydantic import BaseModel, Fieldfrom langgraph.graph import StateGraph, START, ENDfrom langgraph.types import Sendfrom langchain_openai import ChatOpenAIfrom langchain_core.messages import HumanMessage, SystemMessagellm = ChatOpenAI( model="qwen2.5-1.5b-instruct-q4_k_m.gguf" , base_url="http://127.0.0.1:11433/v1" , api_key="dummy" , temperature=0.1 , max_tokens=1024 , ) class Section (BaseModel ): name: str = Field( description="报告这个章节的名称" , ) description: str = Field( description="简要描述本章要覆盖的主题和内容要点" , ) class Sections (BaseModel ): sections: List [Section] = Field( description="报告的所有章节列表" , ) planner = llm.with_structured_output(Sections) class State (TypedDict ): topic: str sections: list [Section] completed_sections: Annotated[ list , operator.add ] final_report: str class WorkerState (TypedDict ): section: Section completed_sections: Annotated[list , operator.add] def orchestrator (state: State ): """编排器节点:生成报告整体大纲,输出多个章节规划""" report_sections = planner.invoke( [ SystemMessage(content="为用户生成一份报告的章节规划。" ), HumanMessage(content=f"报告主题:{state['topic' ]} " ), ] ) return {"sections" : report_sections.sections} def llm_call (state: WorkerState ): """工作器节点:单个worker,负责撰写一个章节内容""" section = llm.invoke( [ SystemMessage( content="按照提供的章节名称和描述撰写报告章节。不要多余开场白,使用markdown格式。" ), HumanMessage( content=f"章节名称:{state['section' ].name} ,章节描述:{state['section' ].description} " ), ] ) return {"completed_sections" : [section.content]} def synthesizer (state: State ): """汇总节点:把所有已经写完的章节拼接成完整报告""" completed_sections = state["completed_sections" ] completed_report_sections = "\n\n---\n\n" .join(completed_sections) return {"final_report" : completed_report_sections} def assign_workers (state: State ): """条件路由函数:为每一个章节,动态派发一个worker任务,使用Send API并行执行""" return [Send("llm_call" , {"section" : s}) for s in state["sections" ]] if __name__ == "__main__" : orchestrator_worker_builder = StateGraph(State) orchestrator_worker_builder.add_node("orchestrator" , orchestrator) orchestrator_worker_builder.add_node("llm_call" , llm_call) orchestrator_worker_builder.add_node("synthesizer" , synthesizer) orchestrator_worker_builder.add_edge(START, "orchestrator" ) orchestrator_worker_builder.add_conditional_edges( "orchestrator" , assign_workers, ["llm_call" ] ) orchestrator_worker_builder.add_edge("llm_call" , "synthesizer" ) orchestrator_worker_builder.add_edge("synthesizer" , END) orchestrator_worker = orchestrator_worker_builder.compile () result = orchestrator_worker.invoke({"topic" : "微服务架构介绍" }) print ("最终完整报告" ) print (result["final_report" ])
代码运行输出提示信息:
最终完整报告
微服务架构(Microservices Architecture)是一种软件架构风格,它将一个大型的应用程序分解成多个小型、独立的、功能单一的服务。每个服务都具有独立的代码库、数据库和部署环境,这些服务通过轻量级的通信协议(
如HTTP、RESTful API或消息队列)进行交互。微服务架构的核心思想是通过将应用程序分解成多个小而独立的服务来提高系统的可扩展性、可维护性和灵活性。
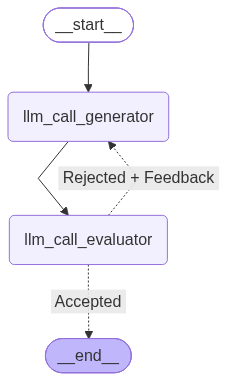
五、评估器与优化器 前面循环图案例是智能体持续自我思考迭代,而评估器与优化器模式是将任务拆分为生成与评估两个独立角色,构建带反馈的自优化闭环。工作流包含两个 LLM 调用分支:优化器(生成器)负责产出内容,评估器专门对产出物按照预设标准打分并生成改进建议。当评估判定内容不达标时,携带反馈信息回到生成器重新迭代,评估达标则直接结束流程。
整体结构流程图:
结构代码参考:
from typing import TypedDict, Literal from pydantic import BaseModel, Fieldfrom langgraph.graph import StateGraph, START, ENDfrom langchain_openai import ChatOpenAIllm = ChatOpenAI( model="qwen2.5-1.5b-instruct-q4_k_m.gguf" , base_url="http://127.0.0.1:11433/v1" , api_key="dummy" , temperature=0.1 , max_tokens=1024 , ) class Feedback (BaseModel ): grade: Literal ["funny" , "not funny" ] = Field( description="判断笑话好笑(funny)还是不好笑(not funny)" ) feedback: str = Field( description="如果笑话不好笑,给出改进的反馈意见。" ) evaluator = llm.with_structured_output(Feedback) class State (TypedDict ): joke: str topic: str feedback: str funny_or_not: str def llm_call_generator (state: State ): """生成器节点:生成笑话,如果有历史反馈就参考反馈重新生成""" if state.get("feedback" ): msg = llm.invoke( f"写一个关于{state['topic' ]} 的笑话,需要参考下面的反馈进行优化:{state['feedback' ]} " ) else : msg = llm.invoke(f"写一个关于{state['topic' ]} 的笑话" ) return {"joke" : msg.content} def llm_call_evaluator (state: State ): """评估器节点:对笑话打分,输出结构化评价结果""" grade = evaluator.invoke(f"评价这个笑话:{state['joke' ]} " ) return {"funny_or_not" : grade.grade, "feedback" : grade.feedback} def route_joke (state: State ): """条件路由函数:根据评估结果决定流程走向 Accepted:笑话合格,结束任务 Rejected + Feedback:笑话不合格,返回生成器重写 """ if state["funny_or_not" ] == "funny" : return "Accepted" elif state["funny_or_not" ] == "not funny" : return "Rejected + Feedback" if __name__ == "__main__" : optimizer_builder = StateGraph(State) optimizer_builder.add_node("llm_call_generator" , llm_call_generator) optimizer_builder.add_node("llm_call_evaluator" , llm_call_evaluator) optimizer_builder.add_edge(START, "llm_call_generator" ) optimizer_builder.add_edge("llm_call_generator" , "llm_call_evaluator" ) optimizer_builder.add_conditional_edges( "llm_call_evaluator" , route_joke, { "Accepted" : END, "Rejected + Feedback" : "llm_call_generator" }, ) optimizer_workflow = optimizer_builder.compile () result = optimizer_workflow.invoke({"topic" : "程序员" }) print ("最终结果" ) print (f"主题:{result['topic' ]} " ) print (f"最终笑话:{result['joke' ]} " ) print (f"评估结果:{result['funny_or_not' ]} " ) print (f"评估反馈:{result['feedback' ]} " )
代码运行输出提示信息:
最终结果
主题:程序员
最终笑话:程序员的笑话:
程序员的笑话是这样的:
评估结果:funny
评估反馈:程序员的笑话确实很有趣,因为它重复了“程序员的笑话是这样的”这句话,形成了一个循环。这种重复和循环的结构使得笑话更加生动和有趣。
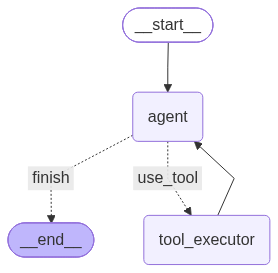
六、代理工具集调用 前面介绍的链式、分支、循环、编排器、评估优化器工作流,流程走向大多是预先定义好的。而工具调用智能体(Agent)具备更高自主决策权,由大模型自主判断是否调用工具、调用哪一个工具、调用几次。适合问题与解决方案无法提前预判的场景,典型就是 ReAct(Reasoning + Acting)范式,模型一边推理思考,一边执行外部动作(调用工具),形成「思考 - 行动 - 观察」循环。
整体结构流程图:
结构代码参考:
from langgraph.graph import StateGraph, MessagesState, START, END from langchain_openai import ChatOpenAI from langchain_core.messages import HumanMessage, SystemMessage, ToolMessage from langchain_core.tools import tool @tool def get_current_time() -> str: "" "获取当前系统时间,当用户询问现在几点、当前时间的时候使用该工具" "" from datetime import datetime return datetime.now().strftime("%Y-%m-%d %H:%M:%S" ) @tool def calculator(a: float , b: float , op: str) -> str: "" " 简单计算器,做加减乘除运算 Args: a: 第一个数字 b: 第二个数字 op: 运算符,可选 + - * / " "" if op == "+" : res = a + b elif op == "-" : res = a - b elif op == "*" : res = a * b elif op == "/" : res = a / b else : return "错误:不支持的运算符" return f"计算结果:{a} {op} {b} = {res}" tools = [get_current_time, calculator] def agent_node(state: MessagesState): llm = ChatOpenAI( model="qwen2.5-1.5b-instruct-q4_k_m.gguf" , base_url="http://127.0.0.1:11433/v1" , api_key="dummy" , temperature=0.3, max_tokens=512, ) llm_with_tools = llm.bind_tools(tools) sys_msg = SystemMessage(content="" " 你是助手小张。可以使用工具完成任务。 - 问时间,调用 get_current_time - 数学计算,调用 calculator - 普通聊天,直接回答,不要强行调用工具 " "" ) messages = [sys_msg] + state["messages" ] response = llm_with_tools.invoke(messages) return {"messages" : [response]} def tool_executor_node(state: MessagesState): tool_map = {t.name: t for t in tools} last_ai_msg = state["messages" ][-1] tool_messages = [] for tool_call in last_ai_msg.tool_calls: tool_name = tool_call["name" ] tool_args = tool_call["args" ] selected_tool = tool_map[tool_name] tool_result = selected_tool.invoke(tool_args) tool_messages.append( ToolMessage(content=str(tool_result), tool_call_id=tool_call["id" ]) ) return {"messages" : tool_messages} def should_use_tools(state: MessagesState): last_msg = state["messages" ][-1] if last_msg.tool_calls: return "use_tool" else : return "finish" if __name__ == "__main__" : builder = StateGraph(MessagesState) builder.add_node("agent" , agent_node) builder.add_node("tool_executor" , tool_executor_node) builder.add_edge(START, "agent" ) builder.add_conditional_edges( source ="agent" , path=should_use_tools, path_map={ "use_tool" : "tool_executor" , "finish" : END } ) builder.add_edge("tool_executor" , "agent" ) graph = builder.compile() current_state = {"messages" : []} while True: user_input = input("\n你:" ) if user_input.strip().lower() == "quit" : print ("退出程序" ) break current_state = graph.invoke({ **current_state, "messages" : current_state["messages" ] + [HumanMessage(content=user_input)] }) ai_reply = current_state["messages" ][-1] print (f"小张:{ai_reply.content}" )
代码运行输出提示信息:
对话已启动,输入 quit 退出

你:计算1+1
小张:计算结果是:1.0 + 1.0 = 2.0

你:quit
退出程序